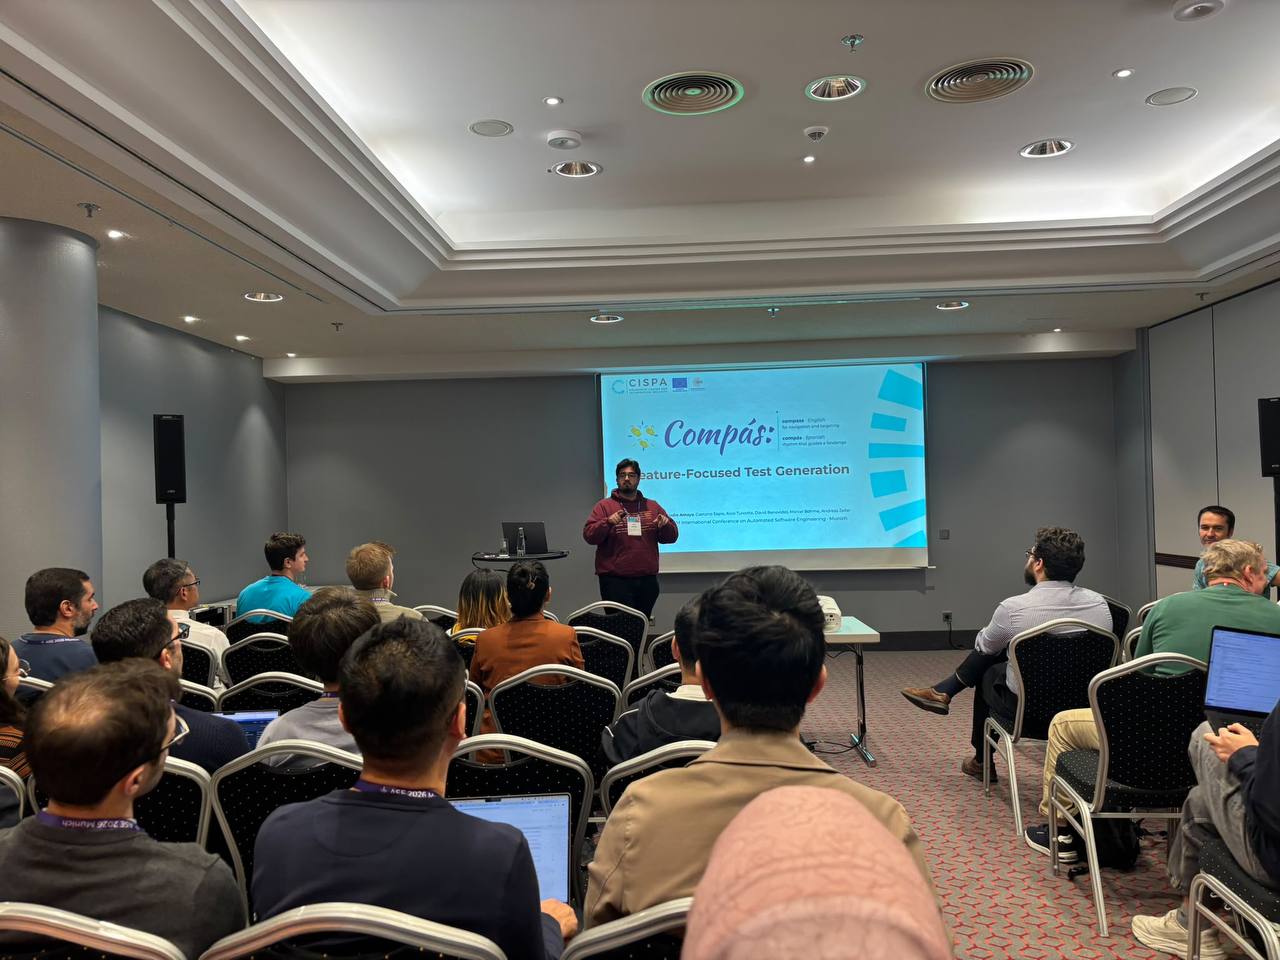
José Antonio Zamudio Amaya presentó el artículo “Feature-Focused Test Generation” en la 41.ª IEEE/ACM International Conference on Automated Software Engineering (ASE 2026). El congreso se celebró en Múnich (Alemania) del 12 al 16 de octubre de 2026. La presentación tuvo lugar en el track principal el miércoles 14 de octubre, en el Forum 7, y se completó con una sesión de póster durante toda esa jornada.
Los autores del artículo son José Antonio Zamudio Amaya, Gaetano Sapia, Alexi Turcotte, Marcel Böhme y Andreas Zeller (CISPA Helmholtz Center for Information Security y MPI-SP), junto con David Benavides (Instituto de Ingeniería Informática, Universidad de Sevilla). Se trata de la primera publicación conjunta entre Diverso Lab y CISPA. El trabajo une dos comunidades de investigación: las pruebas basadas en lenguajes y la ingeniería de líneas de producto software.
Qué propone el trabajo
Los generadores de pruebas basados en especificaciones producen entradas válidas que cubren todo el espacio de entrada de un sistema. Esa amplitud es un inconveniente cuando se quiere probar una característica concreta, por ejemplo una parte de un parser que acaba de modificarse.
Feature-Focused Test Generation (FFTG) aborda este problema como un problema de configuración, en tres pasos:
- Extrae automáticamente un modelo de características a partir de la especificación de entrada.
- El tester selecciona las características que le interesan.
- FFTG especializa la especificación para que solo esas características varíen en las entradas generadas.
El enfoque está implementado en Compás, un prototipo de código abierto construido sobre el generador de pruebas FANDANGO. Compás exporta sus modelos de características en UVL (Universal Variability Language), lo que permite usarlos directamente con las herramientas existentes de análisis de modelos de características.
Resultados principales
La evaluación abarcó diez formatos de entrada reales procesados por siete bibliotecas de parsers, entre ellos formatos de imagen, audio, archivos comprimidos, documentos y configuración. Los resultados muestran que:
- Las entradas generadas siguen siendo válidas en su totalidad, y se mantienen la diversidad y la cobertura.
- Los slices dirigidos alcanzan siempre la región de código de la característica elegida. De media, todas sus entradas ejercitan esa región, frente al 26 % de la generación no dirigida.
- Es posible trazar qué código ejercita cada característica, lo que facilita las pruebas de regresión y la depuración.
- Los conjuntos de pruebas se reducen a uno o dos slices etiquetados por formato. Con ellos, cada región se alcanza con hasta 18,5 veces menos entradas que con la generación de referencia.
Hasta donde saben los autores, es el primer trabajo que aplica técnicas de ingeniería de líneas de producto a las pruebas basadas en especificaciones.
El artículo está disponible en https://doi.org/10.1145/3832783.3837479. El código fuente de Compás y el paquete de replicación pueden consultarse en https://doi.org/10.6084/m9.figshare.31855447.v3
Esta investigación ha sido financiada por la Unión Europea (ERC 101093186 y ERC 101179366) y, parcialmente, por la Agencia Estatal de Investigación a través del proyecto PREMISE (PID2025-171313OB-I00).